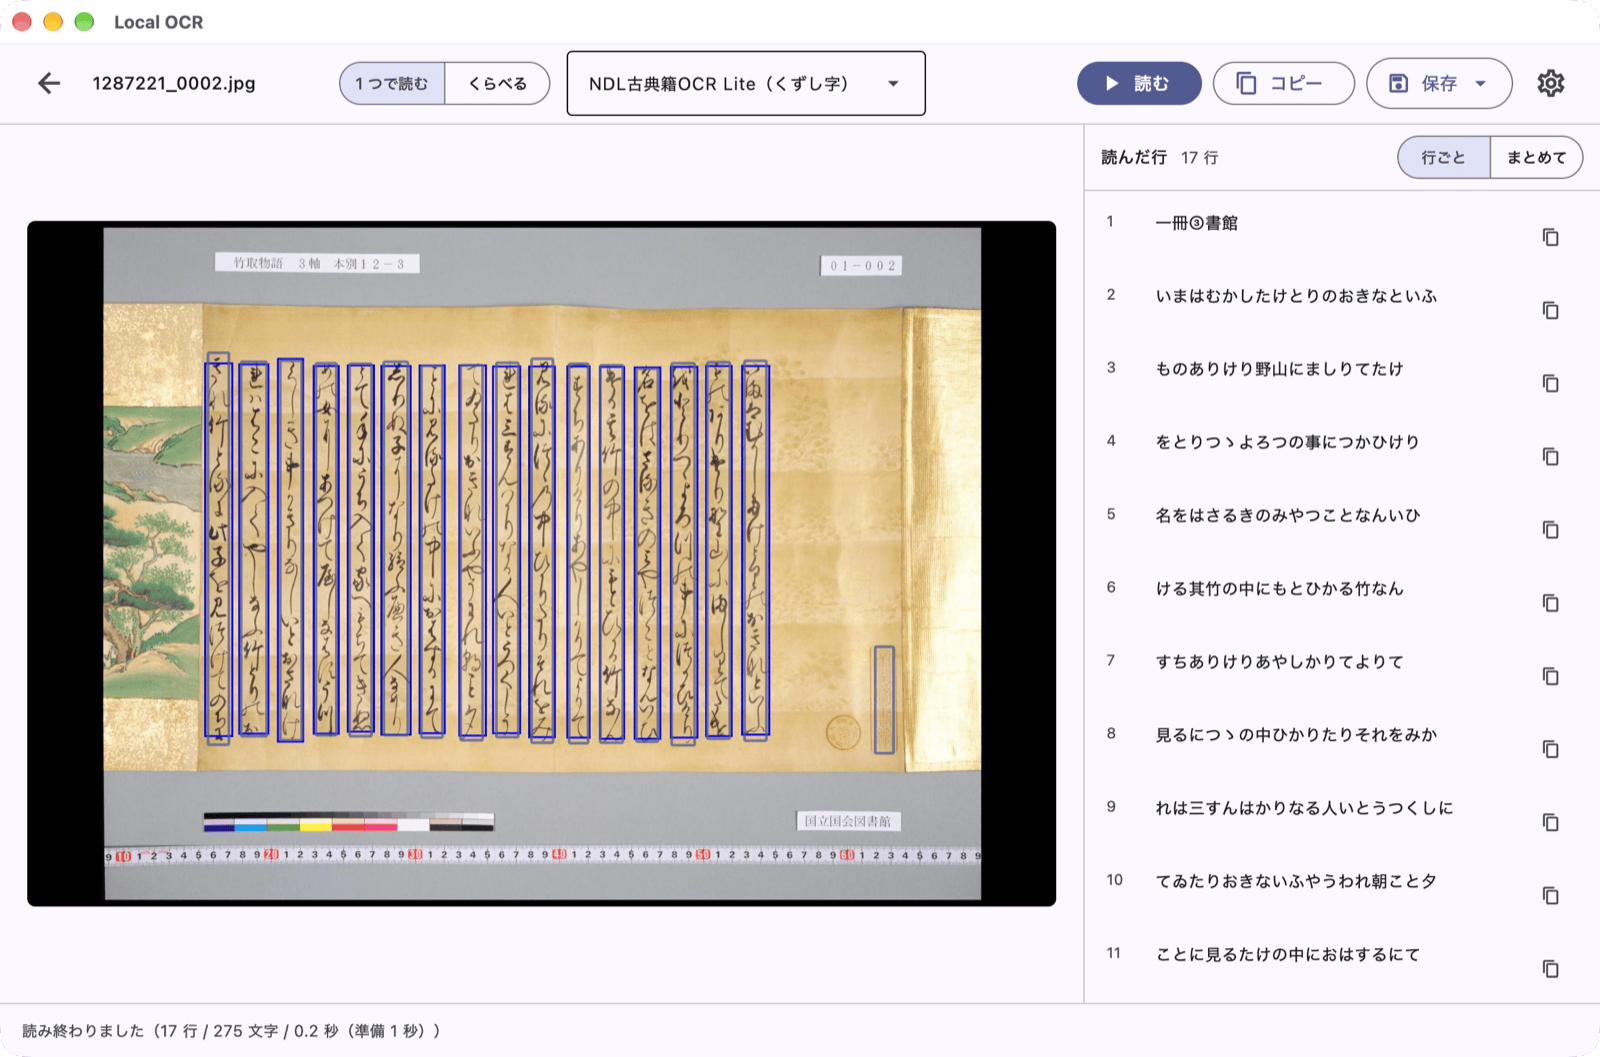
画像を入れると、文字が出てきます。 文字の認識は、すべて手元のパソコンの中で行います。画像はどこへも送りません。
日本語(現代の活字から古典籍のくずし字まで)、中国語(漢文・現代文)、英語、チベット語を読めます。 資料に合わせて、読む道具(認識エンジン)を選べます。
ダウンロード
| Windows | Microsoft ストア(無料。ストアが署名するので警告は出ません) |
| macOS | Releases(署名・公証済みの .dmg) |
最新版の変更点は 更新履歴 にあります。Mac 版は自動では新しい版に替わらないので、ときどきご確認ください。
導入作業は要りません。PaddleOCR-VL のモデルを動かす llama-server はアプリに同梱しています。
読む道具(認識モデル)は、初めて使うときに取得します。
動画で見る
インストール、基本の使い方、いろいろな使い方、校正の画面(TEI/IIIF エディタ)で使う、の 4 本が続けて流れます。声と字幕で説明しています。
同じ内容を、写真つきの手順でも読めます: 使い方
できること
- 入力: 画像ファイル、クリップボード、ページ画像を集めたフォルダ、IIIF マニフェストの URL
- 出力: プレーンテキスト(
.txt)または TEI/XML(.xml) - 比較: 同じページを 2 つの読む道具で読ませて、結果を並べて確かめる
- 日本語・英語の画面、ライト・ダーク両対応
リンク
- 使い方 — 動画と、写真つきの手順
- スクリプトから使う — たくさんの画像をまとめて読む
- ソースコード(MIT)
- プライバシーポリシー
開発
- 中村 覚(東京大学)
- 宮崎 展昌(鶴見大学。PaddleOCR-VL の提案と検証)
- 會谷 佳光(東洋文庫。試用と改善の提案)
連絡先: nakamura.satoru@mail.u-tokyo.ac.jp